让 coding agent 规模化,人们最先想到的瓶颈是模型和 token 预算。我们最先撞上的,却是跑 agent 的那台电脑。
不久之前,我们一直守着一条没写下来的经验:同一台机器上,agent 开到五六个就别再加了。再加,整台机器就会被拖慢,连 agent 自己都跟着卡。
这不是机器配置太低。我们的 agent 主机是一台 14 核、64 GB 的 Mac mini(M4 Pro),仓库是一个约 500 万行代码的 Bazel monorepo。问题出在一个更根本的地方:我们的构建系统是为人设计的,而现在用它的是 agent。
做法可以用一句话概括:让 agent 的电脑只做协调和验证。 Agent 的推理本来就跑在远端的模型上,最后一件还压在本机上的重活是编译。我们把编译交给一个由现有 CI 机器组成的远程执行池,本机只留下 agent 进程、构建分析和必须用到本地设备的测试;再用主干开发加上基于构建图的影响面分析,让一群并行的 agent 持续往同一条主干上合代码,而主干不被打红。
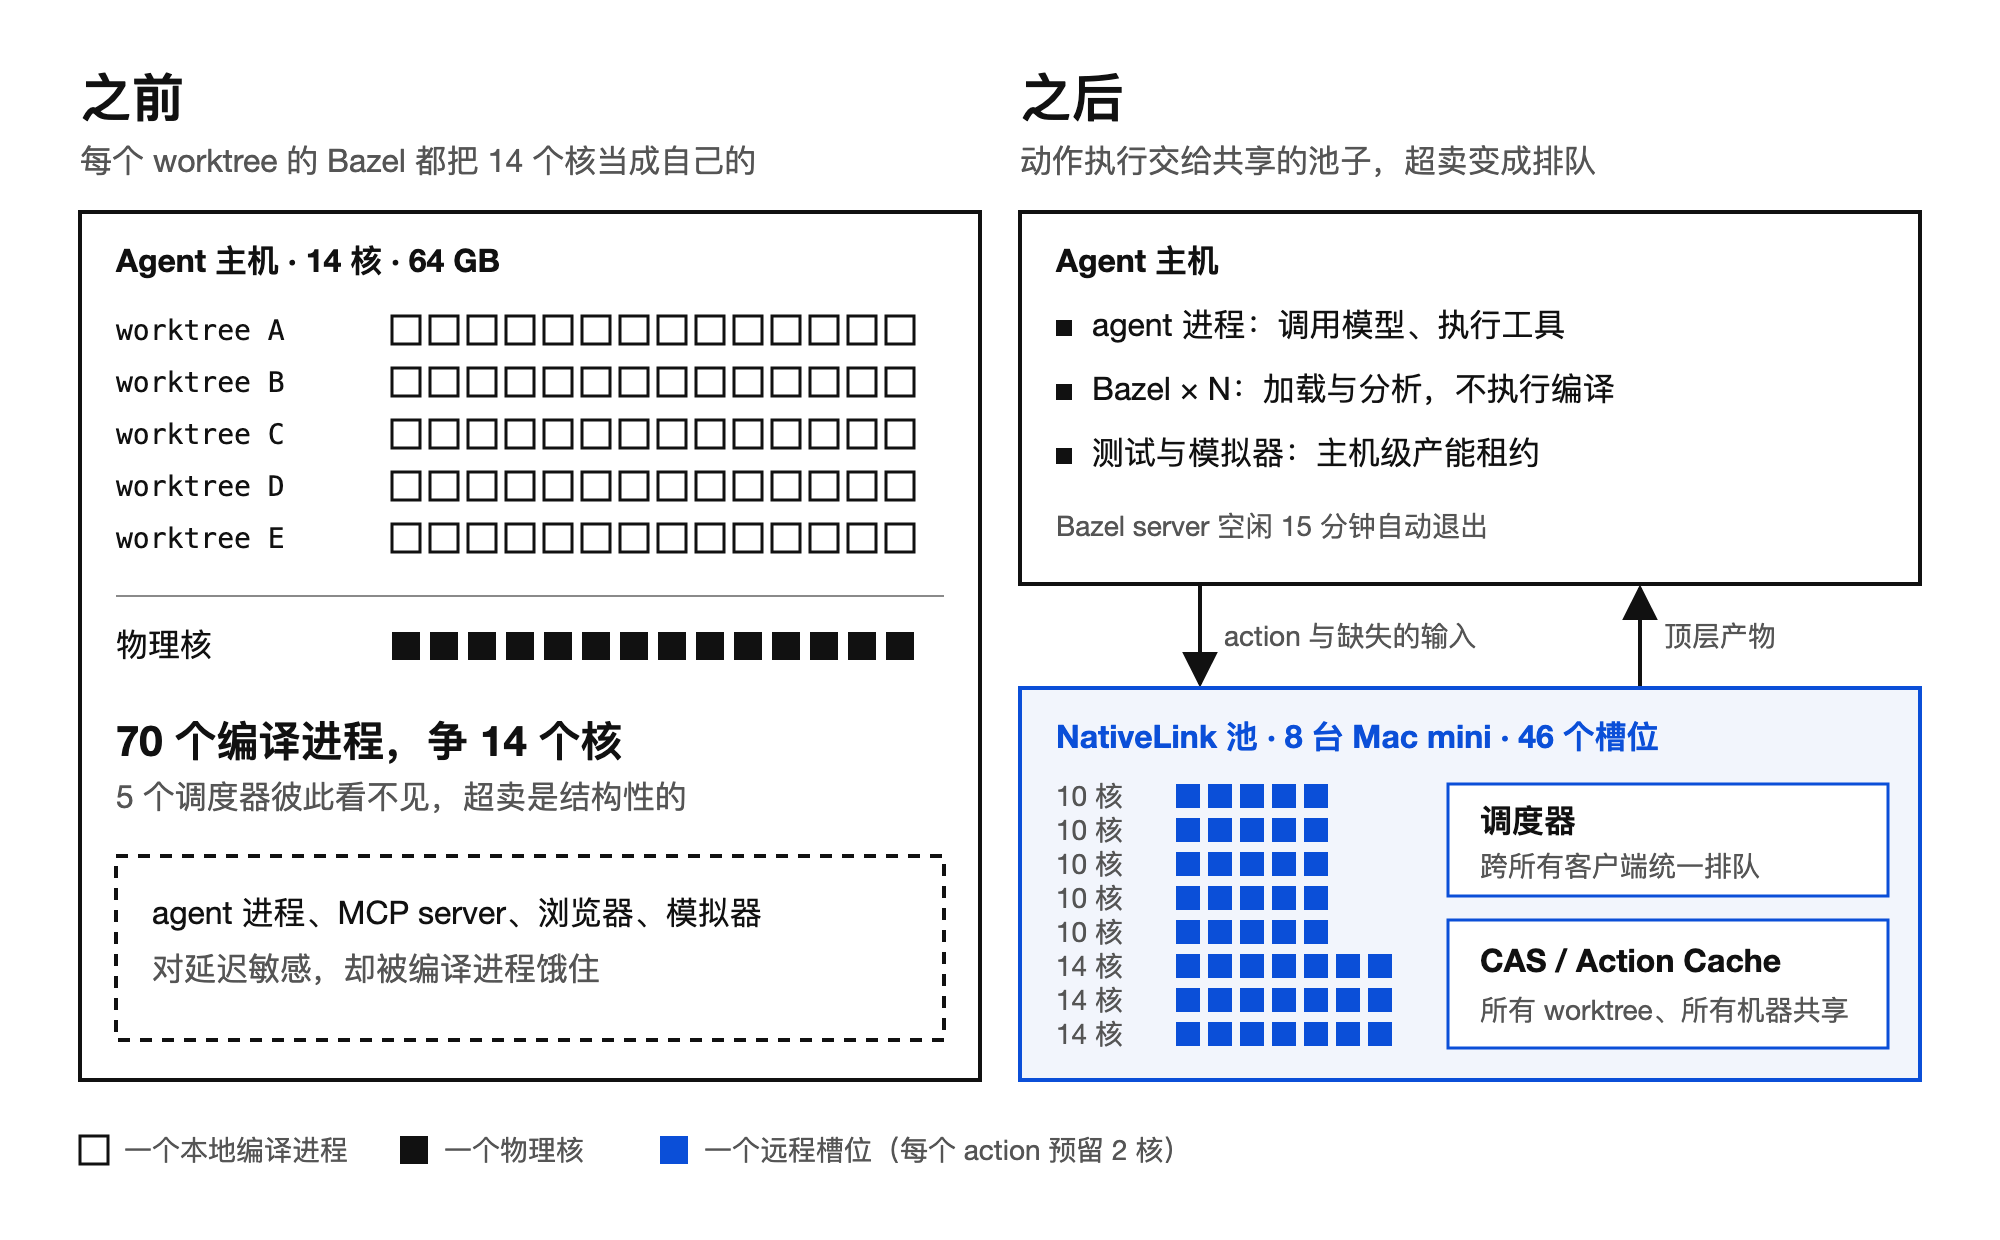
图 1:之前,每个 worktree 的 Bazel 都把整台机器当成自己的;之后,动作执行交给所有客户端共享的池子,本机只留下 agent、构建分析和测试。
为什么五六个 agent 就能拖垮一台 14 核的机器?
人写代码的节奏是串行的:改几行,编译,等结果,盯着报错想一会儿,再改。一次一个构建,构建之间隔着大段的思考时间。一台能流畅跑一个构建的电脑,就是一台好的开发机。
Agent 的节奏完全不同。“改一行、编译、跑测试、读结果、再改”是它的内循环。它的“思考”发生在远端的模型上,不占本机的 CPU;本机看到的,只是一个接一个的构建请求。它也不会累。而且我们不是只跑一个 agent:每个需求一个 agent、一个 git worktree、一个分支,几个需求同时推进。
在 Bazel + worktree 的组合下,每一条这样的内循环都要付三份成本:
- 一个 Bazel server。 Bazel 按 workspace 路径给每个 worktree 分配独立的 server 进程,它是一个常驻的 JVM,我们这里每个约 1.5 GB 内存。
- 一个 output base。 同样按路径分配,装着这个 worktree 的执行根和全部中间产物,从几 GB 到几十 GB。
- 一组本地 action。 编译、链接、代码生成都在本机跑。我们的本地默认配置是
--jobs=HOST_CPUS:每个 Bazel server 都按“这台机器的 14 个核全归我”来调度。
最后一条是卡死的根源。Bazel 的本地资源调度是每个 server 各算各的,彼此看不见。 五个 worktree 同时冷构建,就是五个调度器各自往同一组 14 个核上塞 14 个编译进程:70 个 Swift、Rust、clang 进程争 14 个核和 64 GB 内存,没有任何一方知道另外四个存在。这种超卖是结构性的,调 --jobs 只能在“单个构建变慢”和“多个构建一起卡死”之间二选一。
而 agent 自己也要吃资源。写这篇文章时,这台机器上有 13 个 Claude Code 进程,合计约 5.7 GB 内存,还不算它们的 MCP server、浏览器和 iOS 模拟器。Agent 进程的工具调用对延迟敏感,一旦被编译进程饿住,整个系统的吞吐会一起塌下去。
作为后文所有数字的背景,这是我们的规模:
| 维度 | 规模 |
|---|---|
| 代码 | 约 504 万行、4.6 万个源文件:Swift 193 万、Rust 131 万、Go 79 万、Kotlin 30 万、TypeScript / JavaScript 约 28 万 |
| 构建图 | 一张 Bazel 9 构建图、3,500 多个 BUILD 文件:30 个 iOS app、10 个 Android 工程、Go 后端、Rust 跨端核心、TypeScript Web 应用 |
| 测试 | 近 3,000 个测试目标 |
| Agent 主机 | 1 台 Mac mini(M4 Pro,14 核,64 GB),目前挂着 94 个 git worktree |
| 主干 | 2026-10-01 至 11-10 的 41 天里合入 297 个 MR,其中 133 个来自 agent 的 worktree 分支 |
代码行数按 git 跟踪的源文件统计物理行(含空行与注释),不含 JSON / YAML / Markdown、锁文件和 vendored 的第三方代码。
本机只做协调和验证
把一个 agent 用到的计算拆开看,是五种性质完全不同的负载:
| 负载 | 性质 | 放在哪 |
|---|---|---|
| 模型推理 | 重,但本来就不在本机 | 模型服务 |
| Agent 进程:调用模型、执行工具、读写文件、git | 轻,对延迟敏感 | 本机 |
| 构建分析:加载 BUILD 文件、分析、生成动作图 | 中等,以内存为主 | 本机,每个 worktree 一个 server |
| 动作执行:编译、链接、代码生成 | 重、确定、高度并行,在哪台机器跑都一样 | 远程执行池 |
| 绑定设备的测试:iOS 模拟器、Android 模拟器 | 重,离不开本机设备 | 本机,经主机级的产能租约排队 |
最重的模型推理早就在远端了。剩下的四种里,只有动作执行同时满足“重”和“在哪跑都一样”,而它恰好是本机负载的大头。把它也搬走,本机就只剩下协调(agent 进程和构建分析)和验证(必须在本地设备上跑的测试)。
能搬走它,靠的是 Bazel 的 action 模型。每个 action 都显式声明输入、输出、命令行和环境变量,缓存键就是这些东西的哈希。由此得到两个性质:只要平台匹配,它在哪台机器上执行,结果都一样;只要缓存键相同,它的结果谁都可以直接复用。前者让远程执行成立,后者让远程缓存成立。
所以这套架构由五件东西组成,缺一件都不成立:
- Bazel:action 封闭、内容寻址,这是“能被搬走、能被共享”的前提。
- Monorepo:所有产品在同一张图、同一个缓存键空间里,一个 agent 编过的东西,别的 agent 直接命中;影响面分析也只有在一张完整的图上才做得准。
- Worktree:每个 agent 一份独立的工作副本、一个分支、一个 MR,彼此不踩。
- RBE / RBC:远程执行(Remote Build Execution)把 action 交给集群,远程缓存(Remote Build Cache)让结果在所有 worktree、所有机器之间复用。我们的开发机和 agent 用 RBE,CI 用一套独立的远程缓存。
- 主干开发(Trunk-Based Development)+ 影响面分析:分支活得短、合得勤;每个 MR 只跑它影响到的目标,主干保持常绿。
Worktree:隔离要便宜,前提是共享该共享的
在我们的工作方式里,一个 agent 对应一个 worktree、一个分支、一个 MR。Worktree 共享同一个 git 对象库,创建时只需要检出文件,不用再克隆一遍。但 git 层面便宜,不等于构建层面便宜:output base 按 workspace 路径分配,一个新 worktree 在 Bazel 眼里就是一个从没见过的新仓库,没有分析缓存,也没有任何产物。如果什么都不共享,每开一个 agent 就是一次全量冷构建。
所以这一层的原则是:工作副本和执行状态各自独立,一切能按内容寻址的东西全局共享。
| 资源 | 每个 worktree 独占 | 全局共享 |
|---|---|---|
| 工作副本与分支 | ✓ | git 对象库 |
| Bazel server、output base | ✓(按路径分配) | |
| 本地 action 缓存(disk cache)、外部依赖缓存(repository cache) | 整台主机一份,按大小和时间 GC | |
| 远程 CAS / Action Cache | 所有接入 RBE 的机器、所有 worktree | |
| 本地起的后端服务端口 | ✓(按 worktree 名哈希出 0–499 的端口偏移) | |
| iOS 模拟器 | 主机级产能租约,排队准入 |
独占的那部分必须能自己回收,否则 94 个 worktree 很快就会把机器撑爆:
- Bazel server 空闲 15 分钟自动退出(
--max_idle_secs=900)。94 个 worktree,此刻常驻的 Bazel server 只有 2 个。 - output base 由一个每 15 分钟运行一次的清扫器回收,按 worktree 的状态分级:worktree 已删除的,立刻回收;提交已合进主干的,安静 24 小时后回收;还有未合入提交的,安静 72 小时后回收;磁盘紧张时,门槛统一降到 30 分钟。它只删构建缓存,从不删 worktree,判断失误的最坏结果只是一次重建。即便如此,这台机器的 Bazel 存储还是单独放在一块 4 TB 的卷上,目前用了 1.5 TB。
另外有两条规则,是 agent 时代特有的。
第一条:一个 worktree 只有一个验证 owner。 两个 Bazel 命令撞上同一个 output base,后来的那个会等锁。对一个急着完成任务的 agent 来说,最顺手的解法是另起一个:--output_base=/tmp/build-$$。看起来是并行了,实际上凭空造出一个冷的 output base:全量重建,再吃几十 GB 磁盘,再和所有 worktree 抢一遍核。
人很少这么干,agent 会。所以这条规则不能只是“最佳实践”,而要写进 agent 会读、CI 会查的地方。仓库给 agent 的指南要求:把目标合并到一次 Bazel 调用里,让 Bazel 自己串行化不可避免的重叠。同时,一份面向 agent 的不变量清单在 Makefile 和所有脚本里禁止这几个参数,违反即 CI 失败(这类清单的来历见写给 agent 的不变式):
id = "build-output-ownership"
paths = ["Makefile", "**/*.mk", "**/*.sh", ...]
invariant = "Bazel output ownership is per worktree and the host policy is its single writer ..."
forbid = ["*--output_base*", "*--output_user_root*", "*--ignore_all_rc_files*"]
第二条:构建进行中,输入可能正在被改。 人很少在构建跑着的时候改源文件,agent 却经常一边编译一边继续编辑。Action 执行期间输入被改了,结果就是“按旧内容算出的缓存键,配上按新内容编出的产物”;一旦写进全机共享的 disk cache 或远程缓存,污染的是所有人。我们开了 --guard_against_concurrent_changes=full:执行期间任何输入发生变化,结果就不发布到缓存。Bazel 9 默认的 lite 只检查主仓库的源文件,在缓存被几十个 worktree 共享的场景下不够。
真正稀缺的物理资源,则交给主机级的仲裁者。本地起的后端服务按 worktree 名哈希出端口偏移,几十套开发环境同时运行,端口互不冲突。iOS 模拟器经由一个主机级的产能租约准入:同时跑 UI 测试的 worktree 一多,超出主机产能的那部分会排队,而不是再多拉起几台模拟器。
用 8 台现成的 CI Mac mini 搭一个 NativeLink 池
我们的构建里有大量 Apple 平台的 action:Swift 编译、资源编译、签名、打包。它们需要 Xcode,也就需要 macOS:远程执行池里必须是 Mac。我们选了 NativeLink:用 Rust 写成,源码公开(FSL-1.1-Apache-2.0 许可,每个版本两年后转为 Apache-2.0),实现了 Bazel 的 Remote Execution API,worker 可以作为原生进程直接跑在 macOS 上。
硬件上我们没有新买机器。8 台 Mac mini 本来就是 GitLab 的 macOS runner,每台机器上加一个以 launchd 系统服务常驻的 NativeLink worker,把 CI 机器的空闲算力借给开发机和 agent。
| 组件 | 规格 |
|---|---|
| 调度器 + 中心 CAS / Action Cache | 1 台 Linux VM:8 vCPU、15 GiB;CAS 上限 1.6 TB,抽样的几天里每天新写入 38–133 GB |
| Worker | 8 台 Mac mini:5 台 10 核 16 GB,3 台 14 核 M4 Pro(48 / 64 GB),共 92 核 |
| 槽位 | 每个 action 预留 2 核,共 46 个并发槽位,所有客户端共享 |
| 版本 | NativeLink 1.8.0;worker 另带两个我们提交给上游的补丁(见下一节) |
客户端只需要一个按次启用的 Bazel 配置:
# rbe.bazelrc:只在 --config=rbe 时生效
common:rbe --remote_executor=grpc://<pool>:50051
# 用执行器自己的 CAS 和 Action Cache:输入传到别处,worker 读不到
common:rbe --remote_cache=
common:rbe --remote_instance_name=

# 每台 worker 都声明这些属性;cpu_count 是一个 action 预留的核数
common:rbe --remote_default_exec_properties=OSFamily=darwin
common:rbe --remote_default_exec_properties=cpu_arch=aarch64
common:rbe --remote_default_exec_properties=cpu_count=2

# 只把所请求目标的产物下载回本机,中间产物留在池子里
common:rbe --remote_download_toplevel
# 池子只缓存 worker 编出来的结果;本机执行的结果留在本机
common:rbe --remote_upload_local_results=false
common:rbe --remote_timeout=180s

# 并发上限由池子决定,而不是本机核数;超出容量时由调度器统一排队
common:rbe --jobs=64

# 测试仍在本机执行:iOS 测试要用本机模拟器,集成测试要连本机起的服务
common:rbe --strategy=TestRunner=sandboxed,local
--jobs=64 这一行,回答的正是前面那个超卖问题:并发由一个看得见所有客户端的调度器统一排队,而不是每个 worktree 各自假设自己拥有整台机器。
几个不那么显然的设计决定:
- 按次启用,用之前先探测。 远程执行没有本地回退,执行器连不上,构建就直接失败。所以它不是默认配置。给 agent 的指南里写明:先用
nc -z探测池子,连不上就去掉--config=rbe,照常本地构建。 - 测试留在本机。 构建上池子,测试在本机执行。iOS 测试离不开本机的模拟器和产能租约,集成测试要连本机起的服务。
- 只下载顶层产物。
--remote_download_minimal什么都不下载,只适合“只看能不能编过”的检查;16 个 app 的顶层产物约 2 GB,可单个产品经千兆网下载只要 1–3 秒,为它冒“下一步缺文件”的风险不值得。 - Worker 不向 action 注入任何环境变量。 Apple action 需要的
DEVELOPER_DIR和SDKROOT,由 worker 按 action 自己携带、本来就属于缓存键的XCODE_VERSION_OVERRIDE等变量推导,规则和 Bazel 本地执行时一模一样;worker 上没有对应版本的 Xcode,action 就失败,而不是换一个 Xcode 编完、写进缓存。我们删掉了 worker 上原本写死的DEVELOPER_DIR、PATH和DYLD_LIBRARY_PATH:三者都不在缓存键里,其中DYLD_LIBRARY_PATH让远端的 rustc 一直加载着另一份 libLLVM。 - Worker 的本地缓存只存拉过的输入。 8 台 worker 的本地 CAS 一度都顶在上限的 97–99%。分析之后发现,全池约 250 GB 里有 122 GB 是只出现在单台机器上的 blob,其中近一半是 worker 自己产出的大文件;8 台共同需要的热点输入只有 1.3 GB。于是 worker 的本地 CAS 改为只缓存自己拉取过的输入,产出只写中心 CAS。
效果是这样的(2026-10-23 至 11-09 实测;“强制”指绕过所有缓存、让每个 action 都真正在池子上执行):
| 场景 | 结果 |
|---|---|
| 新建的 worktree:空 output base,不用本机 disk cache,池子缓存命中 | 单个 iOS app 12 秒;16 个 iOS app 46 秒 |
| 一个 iOS app 的全量构建 | 1,503 个 action 全部远程执行,本机零执行,180 秒 |
| 另一个 iOS app,host 工具链已热 | 1,579 个远程 action,275 秒,关键路径 189 秒 |
| 9 个 iOS / watchOS 产品,强制远程 | 7,062 个 action,0 失败 |
| 8 个 Android 产品,强制冷构建 | 10,528 个 action 里 9,192 个远程执行,0 失败,19.5 分钟 |
| 1,204 个 Rust 目标,强制冷构建 | 3,442 个 action,1 个偶发失败,重跑即过 |
对 agent 来说,第一行最重要:worktree 一出生就是热的。 本机的 disk cache 只装着这台机器自己编过的东西,池子的 CAS 则是所有接入 RBE 的机器、所有 worktree 编过的东西的并集。
一个 inode,好几个名字
iOS 和 Rust 先迁上了池子,Android 却迟迟上不去。它的整条 JVM 工具链,包括 desugar、资源编译与合并、R 类生成、dex 合并、Kotlin 编译,在池子上间歇性失败,本地却从来不失败。报错五花八门:
FileNotFoundException: …/nativelink/work/<另一个 operation>/…/lib/tzdb.dat
Error loading java.security file
VerifyError: Could not link verifier
线索藏在第一条报错的路径里:JVM 去读的那个目录,属于另一个 action,而那个 action 往往已经结束,目录已经删了。
根因。 NativeLink 的 worker 物化输入时,用硬链接把文件从本地 CAS 放进每个 action 的工作目录。这样不复制数据,快且省盘。但硬链接意味着同一个 inode 有很多名字:CAS 里一个,每个用到它的 action 目录里各一个。
出问题的,是那些靠“自己在哪”去找同伴的程序。HotSpot 用 dladdr 查 libjvm.dylib 的路径,再由此推出 java.home;CPython 由 libpython3.11.dylib 的位置推出标准库在哪;可执行文件经 @executable_path 找 ../lib 下的动态库。而在 macOS 上,dyld 报告一个镜像的路径时,给的是内核最近为这个 inode 记下的那个名字。它可能是 CAS 里的路径,也可能是另一个 action 的目录,而那个目录可能早已被删掉。
于是,一个 action 里的 JVM,会理直气壮地去另一个已经不存在的 action 目录里找时区数据库。
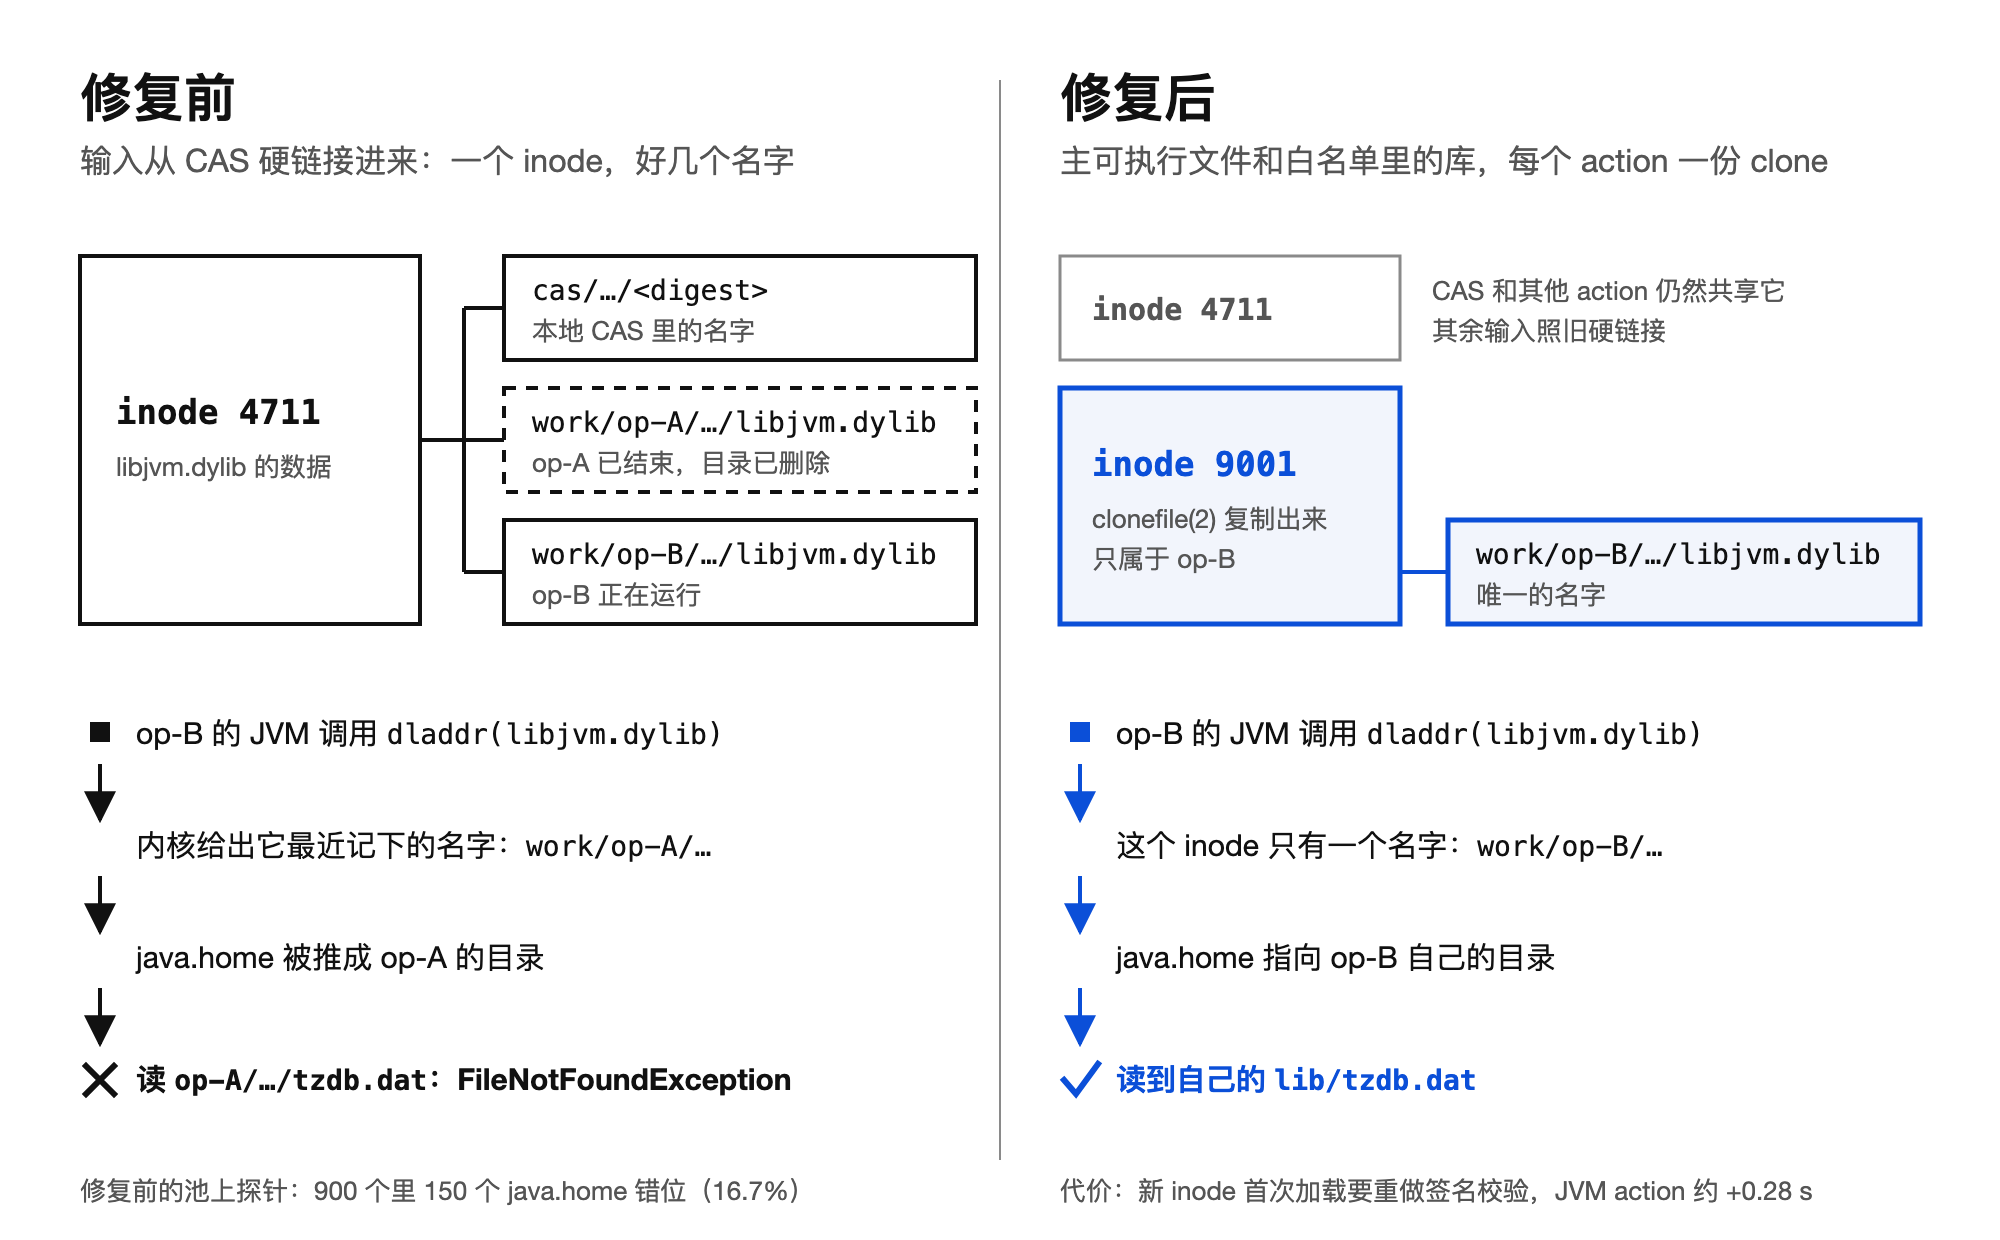
图 2:同一个 inode 的多个名字。dyld 报告的是内核最近记下的那个名字,它可能属于另一个已经结束的 action;clonefile 给每个 action 一份只有一个名字的独立 inode。
同一个机制,我们一层一层剥了三次。
- 最早暴露的是可执行文件:rustc 报
Library not loaded: @rpath/libLLVM.dylib,hermetic Python 找不到自己的libpython。@executable_path走的就是这条路。我们给所有 Mach-O 主可执行文件一份独立 inode;隔离复现里,失败从 2,400 次中的 1,007 次降到 0。 - 但 JVM 照样失败。可执行文件
java修好了,libjvm.dylib却是库,dladdr查的是库自己那个 inode 的名字。于是把libjvm.dylib也加进独立 inode 的名单。 - 修完 JVM 之后的全量验收里,又有一个 Python 工具失败了一次。原来 CPython 也靠
libpython的位置定位标准库,池上的症状是No module named 'copyreg'这类报错。于是把libpython也加进名单。
每一层都先量化,再修。 我们写了一个探针:一个临时包里放 900 个 genrule,每个只跑一次 JDK,打印 java.home 和当前工作目录,再强制它们全部在池子上执行。修复前,900 个里有 150 个(16.7%)的 java.home 指向别的 operation 的目录,8 台 worker 无一幸免。本机压测(8 并发)把规律量得更清楚:
| 输入的物化方式 | java.home 错位 |
|---|---|
| 全部硬链接 | 734 / 1,200 |
| 只给主可执行文件独立 inode | 41 / 3,200 |
主可执行文件 + libjvm.dylib 都独立 | 0 / 4,000 |
修复。 Worker 物化输入时,用 APFS 的 clonefile(2) 给两类文件各自一份独立的 inode:所有 Mach-O 主可执行文件(按文件头里的 MH_EXECUTE 识别,因为 Bazel 把远程输入一律标成可执行,权限位分不出来),以及配置项 private_inode_libraries 点名的库,目前是 libjvm.dylib 和 libpython3.11.dylib。克隆出的文件只有一个名字,dyld 不可能再报错路径。其余输入照旧硬链接。
为什么不全部克隆? 两个原因,都是踩出来的:
- 代码签名校验。 新 inode 第一次被执行或加载时,macOS 会重新做一遍签名校验。在开着 SIP 的 Mac mini 上,每个新 inode 固定多出约 180–200 ms。如果把 rustc 的
librustc_driver(80 MB)和libLLVM(137 MB)也克隆,8 并发下一次最小的 rustc 编译会从 37 ms 涨到 636 ms。 - 头文件身份。 我们试过把整棵输入树都克隆,结果每个头文件都成了独立的 inode。clang 判断两个头文件是不是同一个,看的是 inode,于是一个通过符号链接暴露头文件的 Objective-C 库报出了
duplicate interface definition。这个方案已经撤回。
所以克隆的范围是一份白名单:会用 dyld 自定位、而且确实出过错的镜像。代价是每个 JVM action 多约 0.28 秒、每个 hermetic Python action 多约 0.2 秒的首次加载。冷的整次 Android 构建因此慢几个百分点,增量构建只涉及几个 action,可以忽略;输入里没有 JDK 和 hermetic Python 的 action 不付这笔钱。
rustc 也会用 dladdr 找 librustc_driver,偶尔报 Failed finding sysroot,属于同一类问题。但它的库为了性能保持共享,发生率在万分之一的量级,重跑即过,我们有意暂时不修。
上游。 根因在 NativeLink 的 macOS 输入物化。我们向上游报了 TraceMachina/nativelink#3137,修复提交为 #3138(撰写本文时仍是草稿)。合入之前,我们的 worker 跑的是 1.8.0 加这两个提交。配置里显式写出的 private_inode_libraries 还顺带充当了一道保险:不带补丁的 NativeLink 不认识这个字段,会拒绝启动,而不是带着共享 inode 悄无声息地跑起来。
验收。 部署后,2,700 个 JVM 探针分布在 8 台 worker 上,0 错位;Python 探针在 libpython 加进白名单前有 458 / 2,700 错位,加了之后为 0。随后的强制全量验收里,Android 9,144 个、iOS 6,950 个远程 action,唯一的失败就是一次上面说的 rustc 偶发错误,当天全池 20,327 次 rustc 调用里出现了 2 次。Android 从这一天起也交给了池子。
远程执行是一次对封闭性的全面审计。在一台机器上“恰好能用”的那些关于路径、环境变量和文件系统的假设,到了池子的规模,会以千分之几的概率随机失败。这类问题靠猜是猜不出来的:先写探针把失败率量出来,修完再用同一个探针证明它归零。
主干开发:让 CI 成本跟着改动走
构建压力的另一头在 CI。Agent 让 MR 的数量随并发数线性增长:每个 MR 都跑全量,runner 先撑不住;跑得太少,主干会被打红。而主干一红,所有正在 rebase 的 agent 都会被一起卡住,它们的流水线都会继承这次破坏。
我们的主干开发规则很简单:所有改动都从主干拉出短命的分支,在 MR 里通过自动化检查后合回主干;发布分支由发布系统统一管理,普通的推送不会在上面触发流水线。难点在于“通过哪些检查”。我们的答案是让 Bazel 自己回答:CI 的第一个 job 运行一个用 Rust 写的影响面分析器,它读出 MR 改了哪些文件,在构建图上求出受影响的目标,再生成一条只包含这些目标的子流水线。
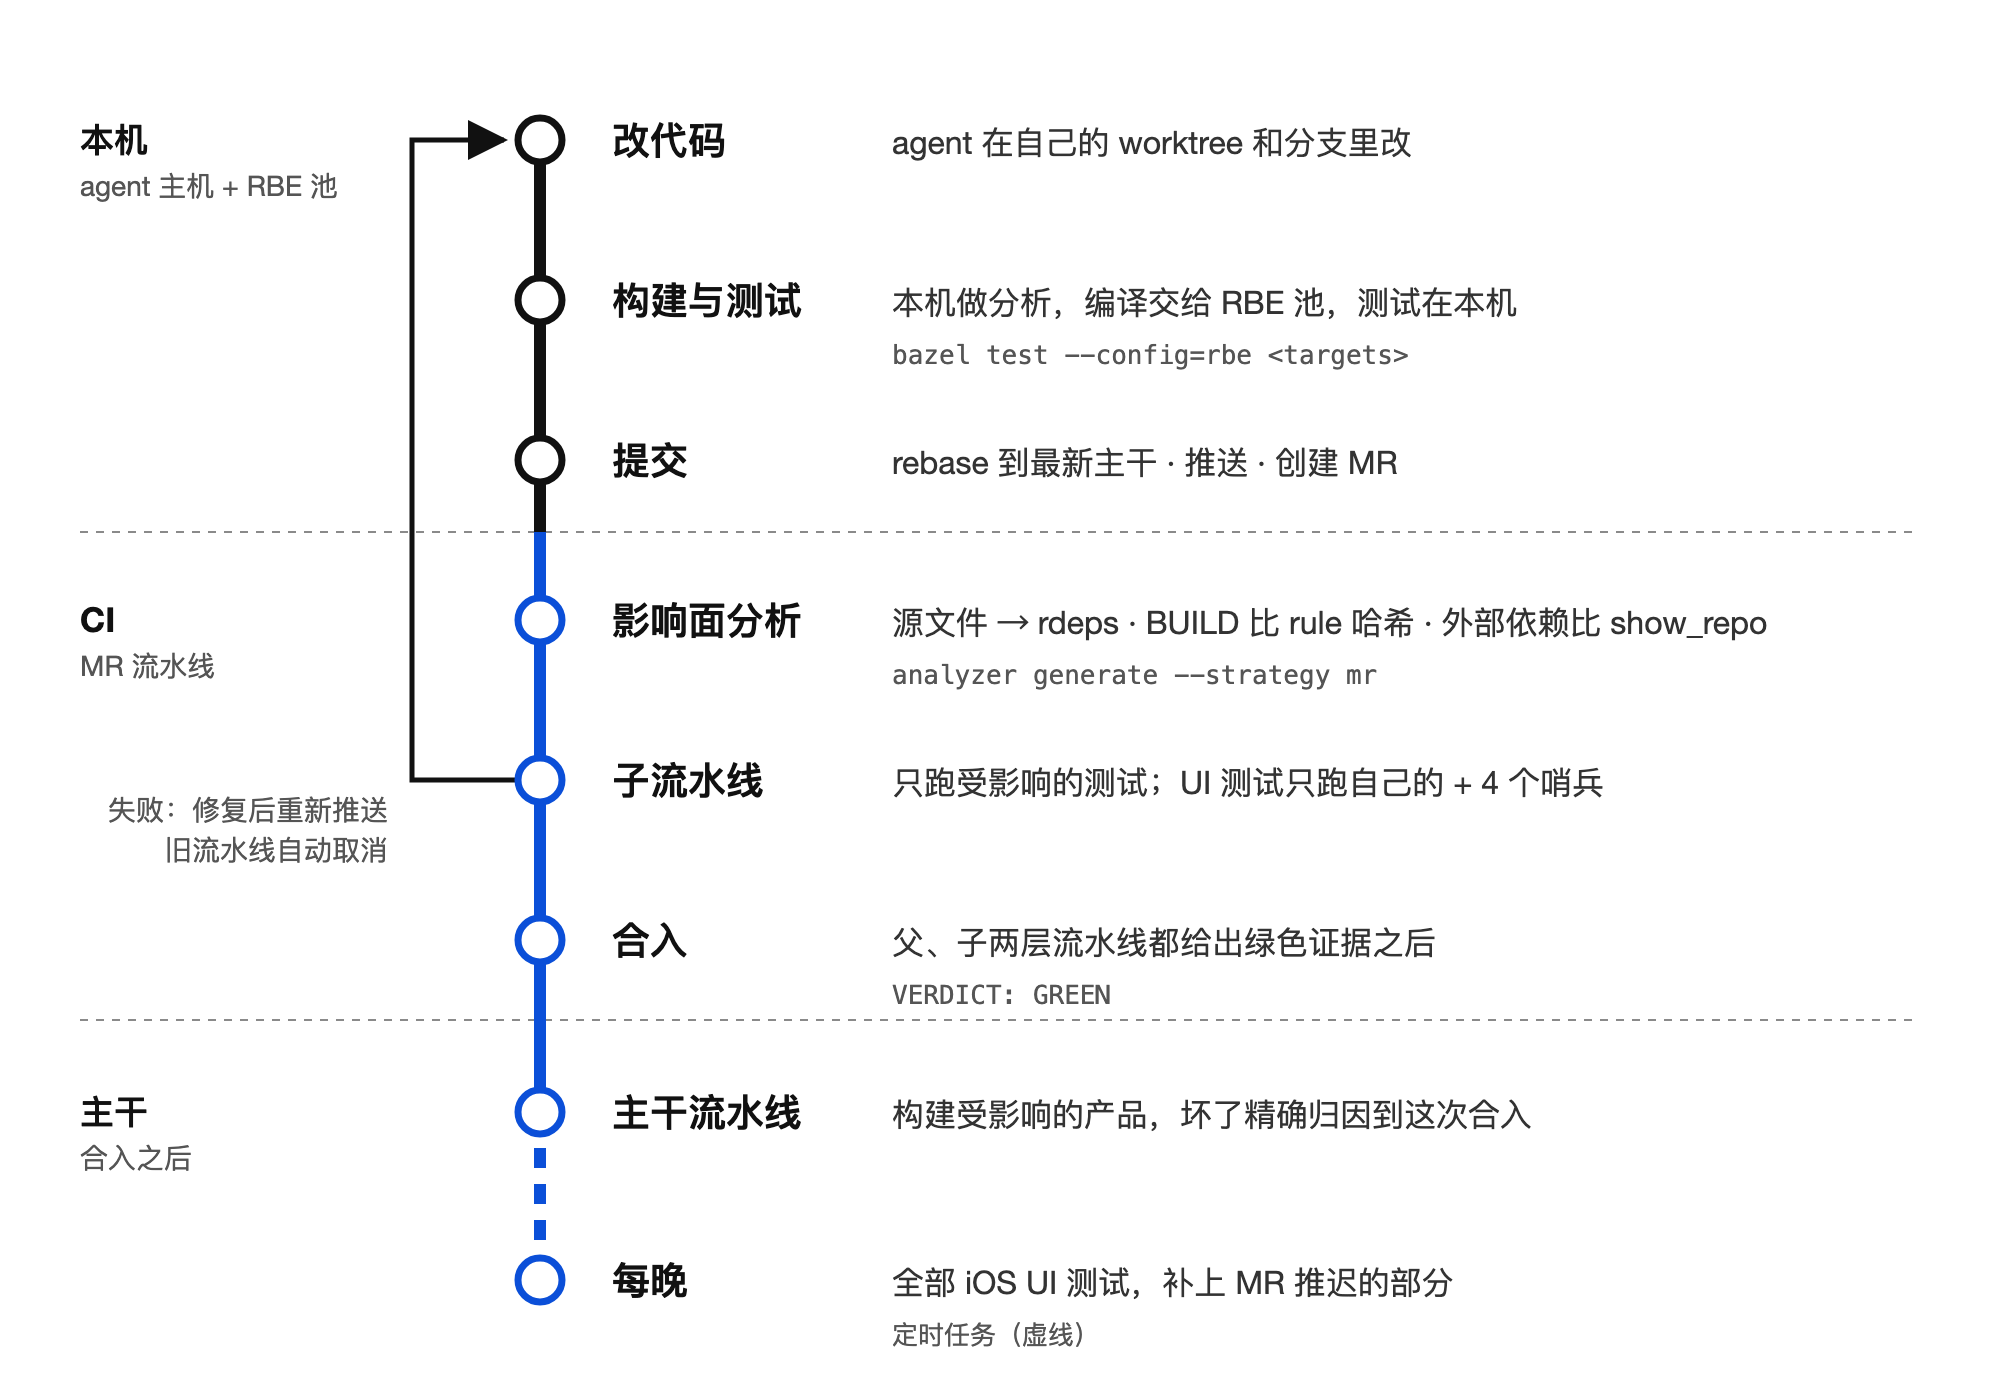
图 3:从 worktree 到主干。每个 MR 只跑它影响到的测试,产品构建在合入之后进行,每晚补跑全部 UI 测试。
改动的文件按“它怎样改变构建图”分类,各有各的回答方式:
| 改动 | 怎么求影响面 |
|---|---|
| 源文件 | 源文件 → 所属 target → 反向依赖(rdeps) |
BUILD / .bzl | 在 base 和 head 上各查一次每条 rule 的属性哈希与实现哈希(bazel query --proto:include_synthetic_attribute_hash),只有真正变了的 rule 进 rdeps |
外部依赖:MODULE 片段、锁文件、go.mod、Maven 锁、补丁 | 比较 base 与 head 上 bazel mod show_repo 解析出的外部仓库定义,只把定义变了的仓库在图里的消费者交给 rdeps |
构建配置:.bazelrc、平台、toolchain | 整张图 |
| 分析本身出错 | 整张图,原因写进日志 |
最后一行是一条原则:查不出来,不等于没影响。 分析失败只能多花机器时间,不能把漏跑伪装成跑过。
在此之上还有三条策略:
- MR 只跑测试,不构建产品。 iOS 和 Android 的 Debug / Release 构建放在合入之后的主干流水线上。哪次合入把哪个产品构建坏了,红的就是那次合入的主干流水线,归因是精确的。
- UI 测试按“所有权 + 哨兵”挑选。 MR 只跑它改到的那些产品的 UI 测试,外加 4 个哨兵:按“改动波及了它的依赖闭包里多少个目标”排序取前 4。其余的 UI 测试交给每晚的全量任务。夜间任务列出 UI 测试全集的那个查询必须完整,有包加载失败或一个测试都没找到,它就直接失败,而不是少跑。
- 同一个 MR 推了新提交,旧流水线立刻取消。 只有最新提交的结果能决定能不能合。
这些规则都不是拍脑袋定的。我们统计了 9 天(2026-10-26 至 11-03)里 runner 时间都花在了哪:
| 浪费 | 占比 | 对策 |
|---|---|---|
| MR 被新提交取代后,旧流水线仍在跑 | MR runner 分钟的 17%(9 万里的 1.55 万) | 新提交自动取消旧流水线 |
| 改一个外部依赖就判“整张图”:删一个 Go 依赖、加一个 Maven 坐标,所有产品和近 3,000 个测试全部重跑 | MR runner 分钟的 29% | 比较外部仓库定义,只重跑消费者 |
| 只因共享的基础代码被波及而跑的 UI 测试,失败几乎全是 flake 或所有产品同时出现的全局故障 | MR UI 测试分钟的 84%(2.8 万里的 2.34 万) | 自己的 UI 测试 + 4 个哨兵,其余交给夜间 |
BUILD 文件的处理也是同样的思路。以前改了 BUILD 就判整个包、改了 .bzl 就判所有 load 它的包。一个被每个产品都 load 的 registry.bzl,意味着登记一个新产品就要重跑 24 个产品。改成 rule 级别的哈希比较之后,只有真正变了的 rule 才会触发重跑。同一类问题在产品声明一侧的解法,见二十三个产品,一个爆炸半径。
最后一环在 agent 这边
我们给 agent 的合并流程是一个固定的技能(skill):提交,rebase 到最新的主干,推送,创建 MR,等待流水线,拿到“全绿”的证据之后才合并。
“等待流水线”这一步,我们踩过一个很有代表性的坑。我们的流水线有两层:父流水线跑静态检查,生成的子流水线跑受影响的测试。有一次,读取子流水线 job 列表的 API 瞬时返回了空,脚本把“读不到”当成了“没有 job、全部完成”,而父流水线恰好是绿的。于是它对一条后来失败了的流水线发起了合并。
修复后的规则是:绿色需要证据,从来不是默认值。 某一层这一轮没读全,就是“未知”而不是“空”;只要触发子流水线的那个 bridge job 还在跑,子层就没有结束,不管它的 job 列表此刻显示什么。
这和影响面分析里的那条原则是同一件事:在自动化系统里,“不知道”必须失败关闭(fail closed)。 人看到一个奇怪的“0/0”会起疑心,agent 不会。反过来也一样,不该从缺失的证据里造出一个红,见谁跑的测试,谁说了算。
代价,以及还没解决的问题
这套架构不是免费的。下面是我们目前清楚知道的代价和缺口:
- 没有本地回退。 执行器连不上,
--config=rbe的构建直接失败。所以它是按次启用的;池子在办公室的局域网里,离开局域网要另走 Tailscale 这类通道。 - 容量是共享的,还和 CI 混部。 46 个槽位由所有开发机和 agent 共享,CI 作业同时在这几台机器上本地运行。一次批量冷构建能把池子占满几分钟到几十分钟。
- 信任边界是局域网。 池子的 gRPC 端口没有认证,任何连得上的客户端都能写 Action Cache。“本地结果不上传”目前是客户端的约定,不是服务端的强制。
- 两套缓存还没打通。 CI 用的远程缓存(bazel-remote)和 NativeLink 的 CAS 互不相通。
- 测试仍在本机。 编译搬走之后,iOS 模拟器成了本机最大的负载。写这篇文章时,3 台已启动的模拟器的进程合计约 36 GB 常驻内存(RSS,含共享页)。
- 还有几个尾巴。 rustc 的偶发 sysroot 错误;一台 worker 和调度器之间的连接反复断开,原因还在排查;冷构建的关键路径被一个约 9 分钟的 Rust 构建脚本钉住;JDK 目前作为输入随每个 action 发送,前面那 0.28 秒就是它的代价。
可以带走的六条经验
- Agent 是负载发生器,要按“N 个并发构建”来设计。 为单人优化的构建配置,在 N 个 agent 下会结构性地超卖。只有把执行交给一个看得见所有客户端的调度器,超卖才会变成排队。
- 只搬走“重、且在哪跑都一样”的那部分。 Agent 进程、构建分析和绑定设备的测试留在本机,确定性的动作执行交给集群。先把负载按性质分清楚,比任何调参都有效。
- 封闭性是入场券,远程执行是审计。 每一个不在缓存键里的环境变量、每一个靠“自己在哪”找同伴的程序,都是一个潜伏的错误。用探针把失败率量出来,修完再用同一个探针证明它归零。
- 给 agent 的不变量要机器可检查。 Agent 会做局部最优,比如另开一个 output base 绕开锁。规则要写在 agent 会读的地方,也要写在 CI 会查的地方。
- CI 成本要跟改动成正比,而不是跟仓库成正比。 先量清楚 runner 时间花在了哪,再从最大的那块下手。我们的前两大浪费,分别占了 MR runner 时间的 17% 和 29%。
- 失败关闭:未知不是空。 影响面查询失败就跑整张图,UI 测试全集查不完整就让夜间任务失败,流水线状态读不全就不判绿。人会对异常起疑,agent 不会。
下一步
- 把 CI 的远程缓存和 RBE 的 CAS 合成一份,让 CI 编过的东西 agent 直接命中,反过来也一样;
- 接入 Linux worker,把 Go、TypeScript 和一部分 Rust 的 action 分出去(届时调度属性
OSFamily要从优先级匹配改为精确匹配,否则拦不住 Apple 的 action 被派到 Linux 上); - 给池子加上认证,并按 instance 隔离写入;
- 把调度器的配置也纳入仓库,像 worker 一样由仓库渲染;
- 像 Xcode 一样把 JDK 预装到 worker 上,省掉每个 JVM action 的签名校验开销。
构建系统的用户画像变了
回头看,这件事最大的认知转变是:构建系统的用户画像变了。 它服务的不再是一个会等待、会思考、一次只做一件事的人,而是一群并发、不知疲倦、还会做局部最优的机器开发者。Bazel 的封闭性和内容寻址,在人的时代是“让构建更快、更可靠”的工程美德;到了 agent 的时代,它们成了“并行能不能跑起来”的基础设施前提。
现在,我们的 agent 主机只做它最该做的事:协调,以及在本地设备上验证。思考交给模型,编译交给池子,正确性交给主干上的影响面分析。“agent 开到五六个就该停手”的那条经验,正在被我们忘掉。
感谢 Trace Machina 和 NativeLink 社区。